mirror of
https://github.com/Nick-Hogo/AgentSeed
synced 2026-11-15 19:44:23 +08:00
v0.2:LLM角色扮演——模型基础调用参数学习
This commit is contained in:
 guan
@@ -1,7 +1,13 @@
|
||||
# AgentSeed
|
||||
<div align="center">
|
||||
|
||||

|
||||
|
||||
# AgentSeed —— 从零开始的Agent开发教程
|
||||
|
||||
> 播下一颗种子,期待它长成参天大树的那天。
|
||||
|
||||
</div>
|
||||
|
||||
AgentSeed 是一个从零开始构建 AI Agent 的渐进式教学项目。
|
||||
|
||||
项目以 Python 为主,不直接依赖 LangChain 等 Agent Framework,而是从一次最基础的 LLM 调用出发,逐步实现上下文、工具调用、Agent Loop、存储、检索、Skill、MCP、可观测性与评测。
|
||||
@@ -31,6 +37,7 @@ AgentSeed 希望提供一条清晰的学习路径:不从庞大的框架开始
|
||||
- **每步都可运行**:切换到关键提交后,可以观察该阶段新增的能力。
|
||||
- **先实践,再抽象**:抽象从已经运行的代码中产生,而不是提前设计复杂框架。
|
||||
- **覆盖完整链路**:从命令行模型调用,逐步扩展到 Web、RAG、Skill、MCP 和 Eval。
|
||||
- **使用 Anthropic 示例**:当前代码和教程统一以 Anthropic Messages API 为例。
|
||||
|
||||
## 如何学习
|
||||
|
||||
@@ -43,24 +50,13 @@ AgentSeed 希望提供一条清晰的学习路径:不从庞大的框架开始
|
||||
|
||||
你可以跟随主分支持续阅读,也可以切换到某个提交,查看 Agent 是如何一步步构建出来的。
|
||||
|
||||
## 学习路线
|
||||
|
||||
```text
|
||||
LLM 对话
|
||||
→ Agent 的执行、存储与检索
|
||||
→ 格式转换与可观测性
|
||||
→ Skill 技能系统
|
||||
→ MCP 协议接入
|
||||
→ 评测与最终整合
|
||||
```
|
||||
|
||||
### 第一章:LLM 对话
|
||||
|
||||
从一次普通的 HTTP 请求开始,理解应用如何与大语言模型通信。
|
||||
|
||||
主要内容:
|
||||
|
||||
- 调用 OpenAI-compatible 模型接口;
|
||||
- 调用 Anthropic Messages API 兼容接口;
|
||||
- 理解 System、User、Assistant 消息角色;
|
||||
- 保存消息并实现上下文记忆;
|
||||
- 抽象模型客户端;
|
||||
@@ -170,3 +166,14 @@ LLM 对话
|
||||
AgentSeed 最终会形成一个完整但最小的 AI Agent 参考实现:它能够与模型对话、维护上下文、调用工具、等待人工审批、保存与恢复状态、检索外部知识、加载 Skill、连接 MCP Server,并通过 Trace 和 Eval 观察与验证自己的执行过程。
|
||||
|
||||
更重要的是,项目会完整保留它从一颗种子逐步生长起来的过程。
|
||||
|
||||
|
||||
## Star History
|
||||
|
||||
[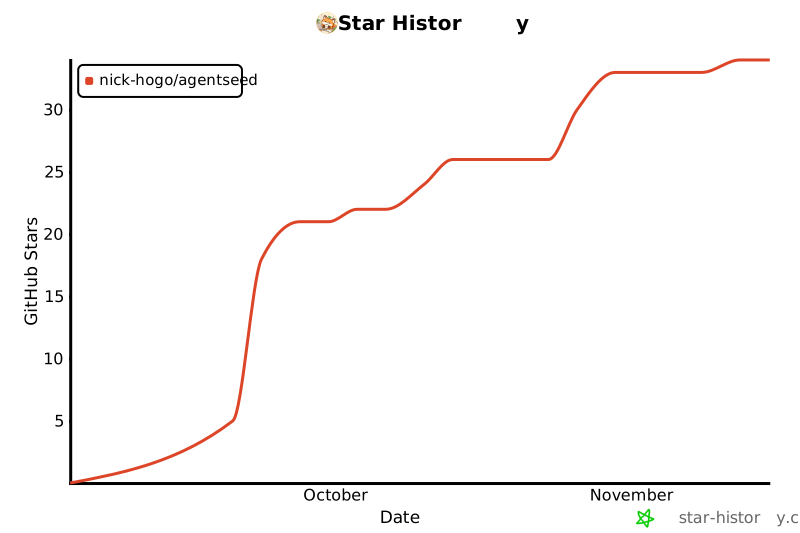](https://www.star-history.com/#Nick-Hogo/AgentSeed&type=date&legend=top-left)
|
||||
|
||||
|
||||
## 相关链接
|
||||
|
||||
- [Linux.do](https://linux.do/):连接开发者与 AI 爱好者的社区。
|
||||
- [AgentSeed GitHub](https://github.com/Nick-Hogo/AgentSeed):项目源码与教程。
|
||||
@@ -3,30 +3,35 @@ import httpx
|
||||
base_url = "https://api.example.com/v1/messages"
|
||||
api_key = "sk-xxxx"
|
||||
model = "claude-fable-5"
|
||||
system_prompt = "你是一只可爱活泼元气猫娘~ 说话末尾带喵~" # 设置模型的身份和行为
|
||||
messages = [] # 保存本次对话的历史消息
|
||||
|
||||
while True: # 持续接收用户输入,实现最基础的命令行对话。
|
||||
while True:
|
||||
user_input = input("You> ")
|
||||
|
||||
# 按照 Anthropic Messages API 协议向模型服务发送 HTTP 请求。
|
||||
messages.append({"role": "user", "content": user_input}) # 添加用户输入的消息到历史消息列表中
|
||||
|
||||
response = httpx.post(
|
||||
base_url,
|
||||
headers={
|
||||
"x-api-key": api_key, # Anthropic 格式的认证信息
|
||||
"anthropic-version": "2023-06-01", # Anthropic API 版本
|
||||
"x-api-key": api_key,
|
||||
"anthropic-version": "2023-06-01",
|
||||
},
|
||||
json={
|
||||
"model": model, # 选择的模型名称
|
||||
"messages": [
|
||||
{"role": "user", "content": user_input}, # 用户输入的消息
|
||||
],
|
||||
"model": model,
|
||||
"max_tokens": 20, # 设置模型最多生成的 Token 数量
|
||||
"system": system_prompt, # 设置模型的身份和行为
|
||||
"messages": messages, # 历史消息列表
|
||||
},
|
||||
timeout=60,
|
||||
)
|
||||
|
||||
# 将 JSON 响应转换为字典,然后取出模型生成的文本。
|
||||
data = response.json()
|
||||
assistant_message = "" # 初始化助手回复的消息
|
||||
print("Assistant>", end=" ")
|
||||
for block in data["content"]: # 循环解析LLM返回信息
|
||||
for block in data["content"]:
|
||||
if block["type"] == "text":
|
||||
assistant_message += block["text"] # 拼接助手回复的消息
|
||||
print(block["text"], end="")
|
||||
print()
|
||||
print()
|
||||
messages.append({"role": "assistant", "content": assistant_message}) # 添加助手回复的消息到历史消息列表中
|
||||

Binary file not shown.
|
After Width: | Height: | Size: 1.7 MiB |
Reference in New Issue
Block a user